
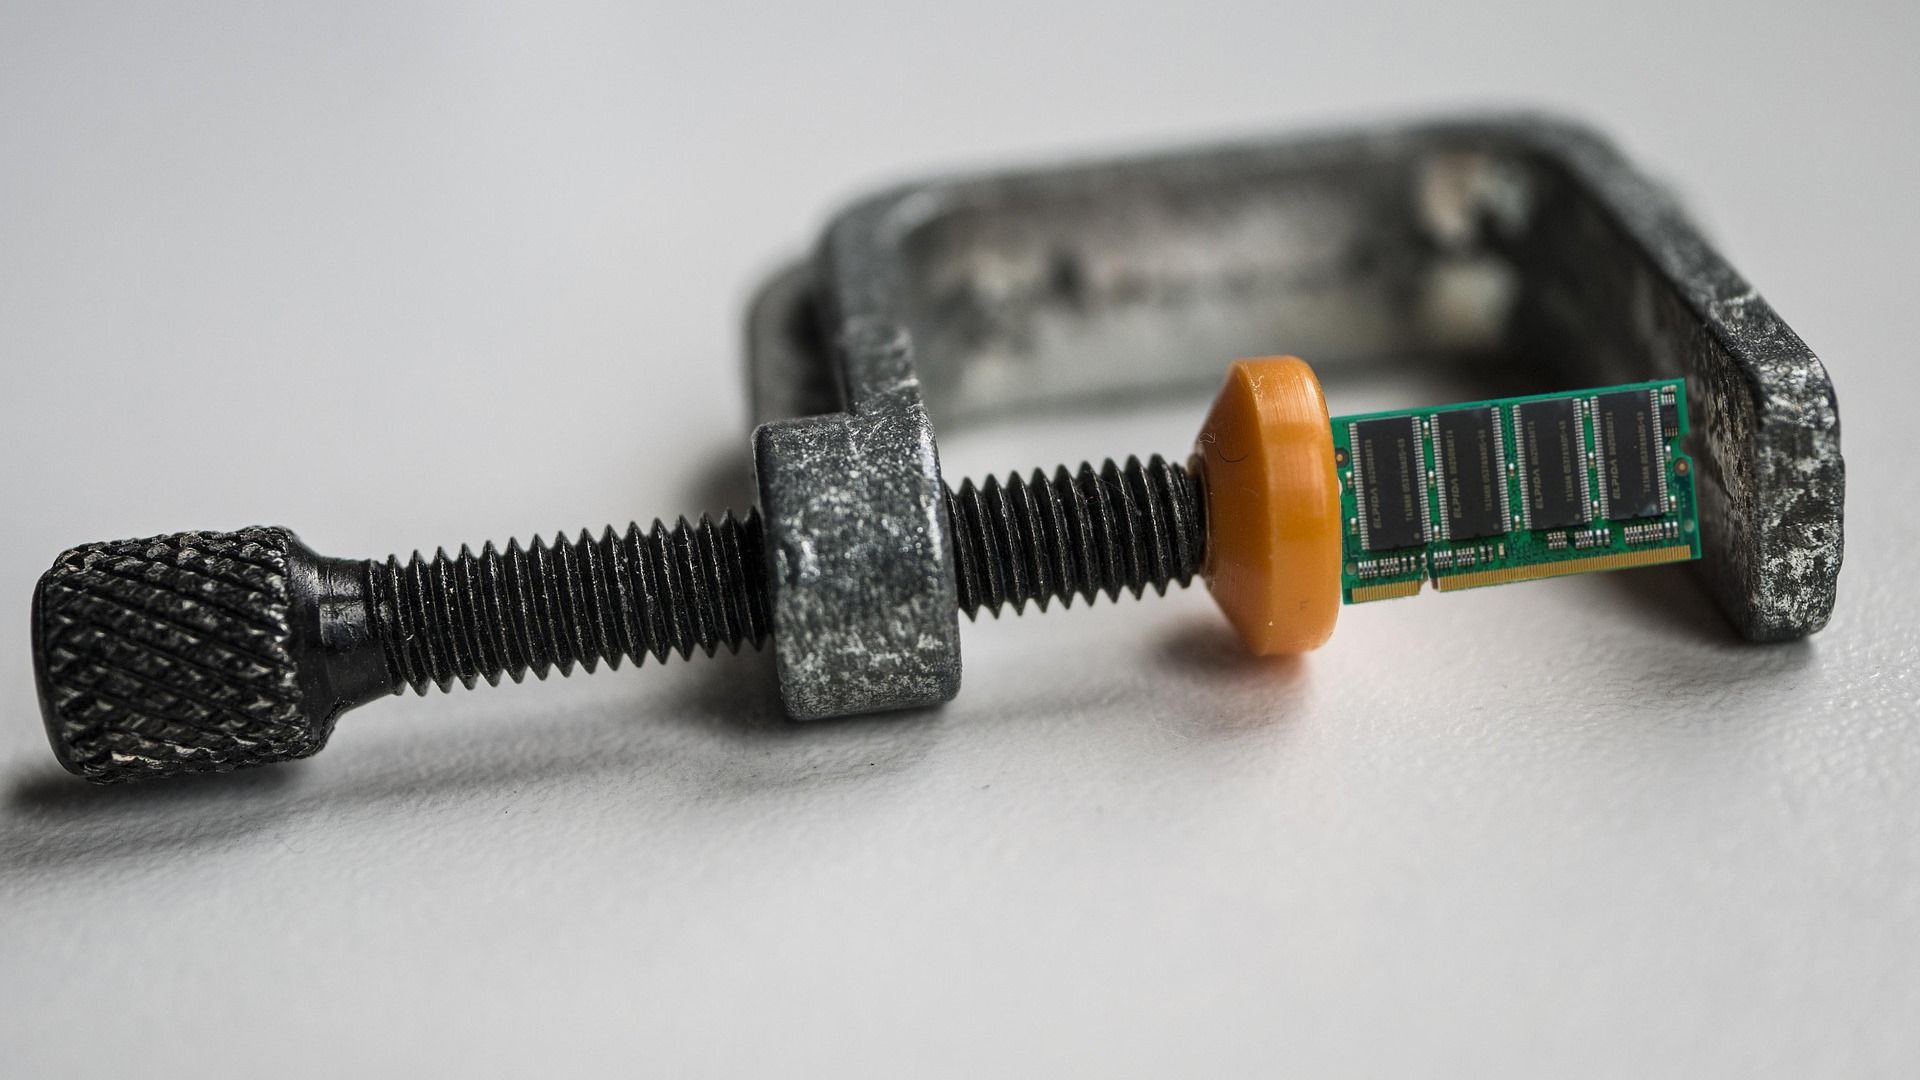
Компания Meta разработала новую технологию сжатия данных под названием CRAM, которая направлена на оптимизацию использования оперативной памяти в среде Linux. Основное отличие CRAM от существующих решений, таких как ZRAM или Zswap, заключается в отказе от использования механизма подкачки на диск. Вместо имитации блочного устройства для временного хранения данных, новая система хранит сжатые объекты непосредственно в оперативной памяти, что позволяет избежать задержек, характерных для традиционных методов управления памятью.
Техническая реализация CRAM предусматривает использование специального узла NUMA, который функционирует как отдельный вычислительный ресурс. Такой подход позволяет ядру Linux продолжать работать со сжатыми данными как с обычными сегментами памяти, используя имеющиеся механизмы миграции и динамического масштабирования. Для предотвращения системных сбоев в моменты высокой нагрузки разработчики внедрили инструмент, известный как Chicken Bit, который временно приостанавливает процессы аллокации, если скорость записи превышает возможности системы сжатия обрабатывать входящий поток информации.
Эффективность технологии подтверждается измерениями производительности при чтении данных. В режиме только для чтения скорость операций достигает 489 миллионов операций в секунду, что превышает показатели ZRAM, которые составляют около 1,1 миллиона операций в секунду. Такое ускорение в 452 раза объясняется устранением накладных расходов на возникновение ошибок доступа к страницам памяти и отказом от взаимодействия со слоем подкачки, что позволяет системе работать со скоростью, близкой к пропускной способности DRAM.
Ситуация существенно меняется при выполнении операций записи, поскольку сжатые данные требуют декомпрессии и переноса в другой домен NUMA для внесения изменений. В тестах с 20 процентами операций записи скорость CRAM превышает производительность ZRAM в 5,4 раза. Несмотря на падение производительности по сравнению с режимом чтения, показатель остается существенным для серверной инфраструктуры, где объемы обрабатываемых данных измеряются терабайтами, а эффективность работы памяти является критическим фактором общей производительности вычислительных систем.
Текущий статус проекта CRAM характеризуется как этап продолжающихся исследований, поскольку разработчики еще не решили проблему точного прогнозирования доступного объема памяти при переменном коэффициенте сжатия. Разные типы данных сжимаются неодинаково, что создает непредсказуемость относительно фактической емкости оперативной памяти. Однако благодаря потенциальной интеграции в ядро Linux, эта технология может получить широкое применение в серверном сегменте и на устройствах с ограниченными ресурсами, где оптимизация использования памяти прямо влияет на стабильность работы программного обеспечения.
